Ein Labor meldete sich bei uns, weil das nächtliche Packen seiner Datenbank nicht mehr funktionierte. SENAITE selbst lief normal. Benutzer meldeten sich an, registrierten Proben, erfassten Ergebnisse und veröffentlichten Berichte. Nichts in der Oberfläche deutete auf ein Problem hin.
Darunter war die Datenbank seit Monaten gewachsen. Der Pack brach
jede Nacht mit einem EOFError ab. Ursache war ein einzelner
abgeschnittener Datensatz, vermutlich geschrieben, als ein Neustart
einen Schreibvorgang unterbrach. Ein Pack muss jeden Datensatz
lesen, auf den noch verwiesen wird. Dieser ließ sich nicht lesen,
also brach der ganze Pack ab. Jede Nacht behielt die Datenbank
alles, was sie hätte verwerfen sollen.
Als klar war, wonach wir suchen, war die Reparatur kurz: Datensatz finden, Verweis reparieren, Pack laufen lassen. Die Datei schrumpfte noch in derselben Nacht auf ihre tatsächliche Größe, ohne Datenverlust. Was wir nicht zurückgeben konnten, waren die Monate, in denen der Fehler unbemerkt blieb.
Diese Lücke schließt proaktives Monitoring.
Warum “die Site ist erreichbar” nicht reicht
Übliches Monitoring beobachtet die Oberfläche: Antwortet der HTTP-Endpunkt, ist die Platte unter 90 Prozent. Für ein LIMS sagt das wenig. SENAITE hält seine Daten in einer Objektdatenbank, die von einigen stillen Jobs gepflegt wird, deren Erfolg niemand sieht. Die Fragen, die sich jeden Tag lohnen, betreffen diese Jobs:
- Lief das Backup letzte Nacht, und ist es plausibel? Nicht nur, ob eine Datei existiert, sondern ob sie aktuell ist, ob ihre Größe zur vorigen passt und ob sie auf einer anderen Platte liegt als die Datenbank.
- Lief der Pack? Und schrumpft die Datenbank danach, oder wächst sie nur?
- Ist die Datenbank konsistent? Ein beschädigter Datensatz ist unsichtbar, bis etwas ihn lesen muss.
- Bekommen Benutzer Fehler, die sie nicht melden? Konfliktfehler, deren Wiederholungen ausgeschöpft sind, Tracebacks, die es vorher nie gab.
- Verschiebt sich etwas? Antwortzeiten einzelner Ansichten, Plattenwachstum zwischen zwei Packs, Kernel-Meldungen zu Speicher oder I/O.
Wer nur prüft, ob SENAITE antwortet, erfährt von einem Problem an dem Tag, an dem es zum Ausfall führt. Wer die fünf Fragen oben prüft, erfährt davon in der Nacht, in der es beginnt.
HealthWatch
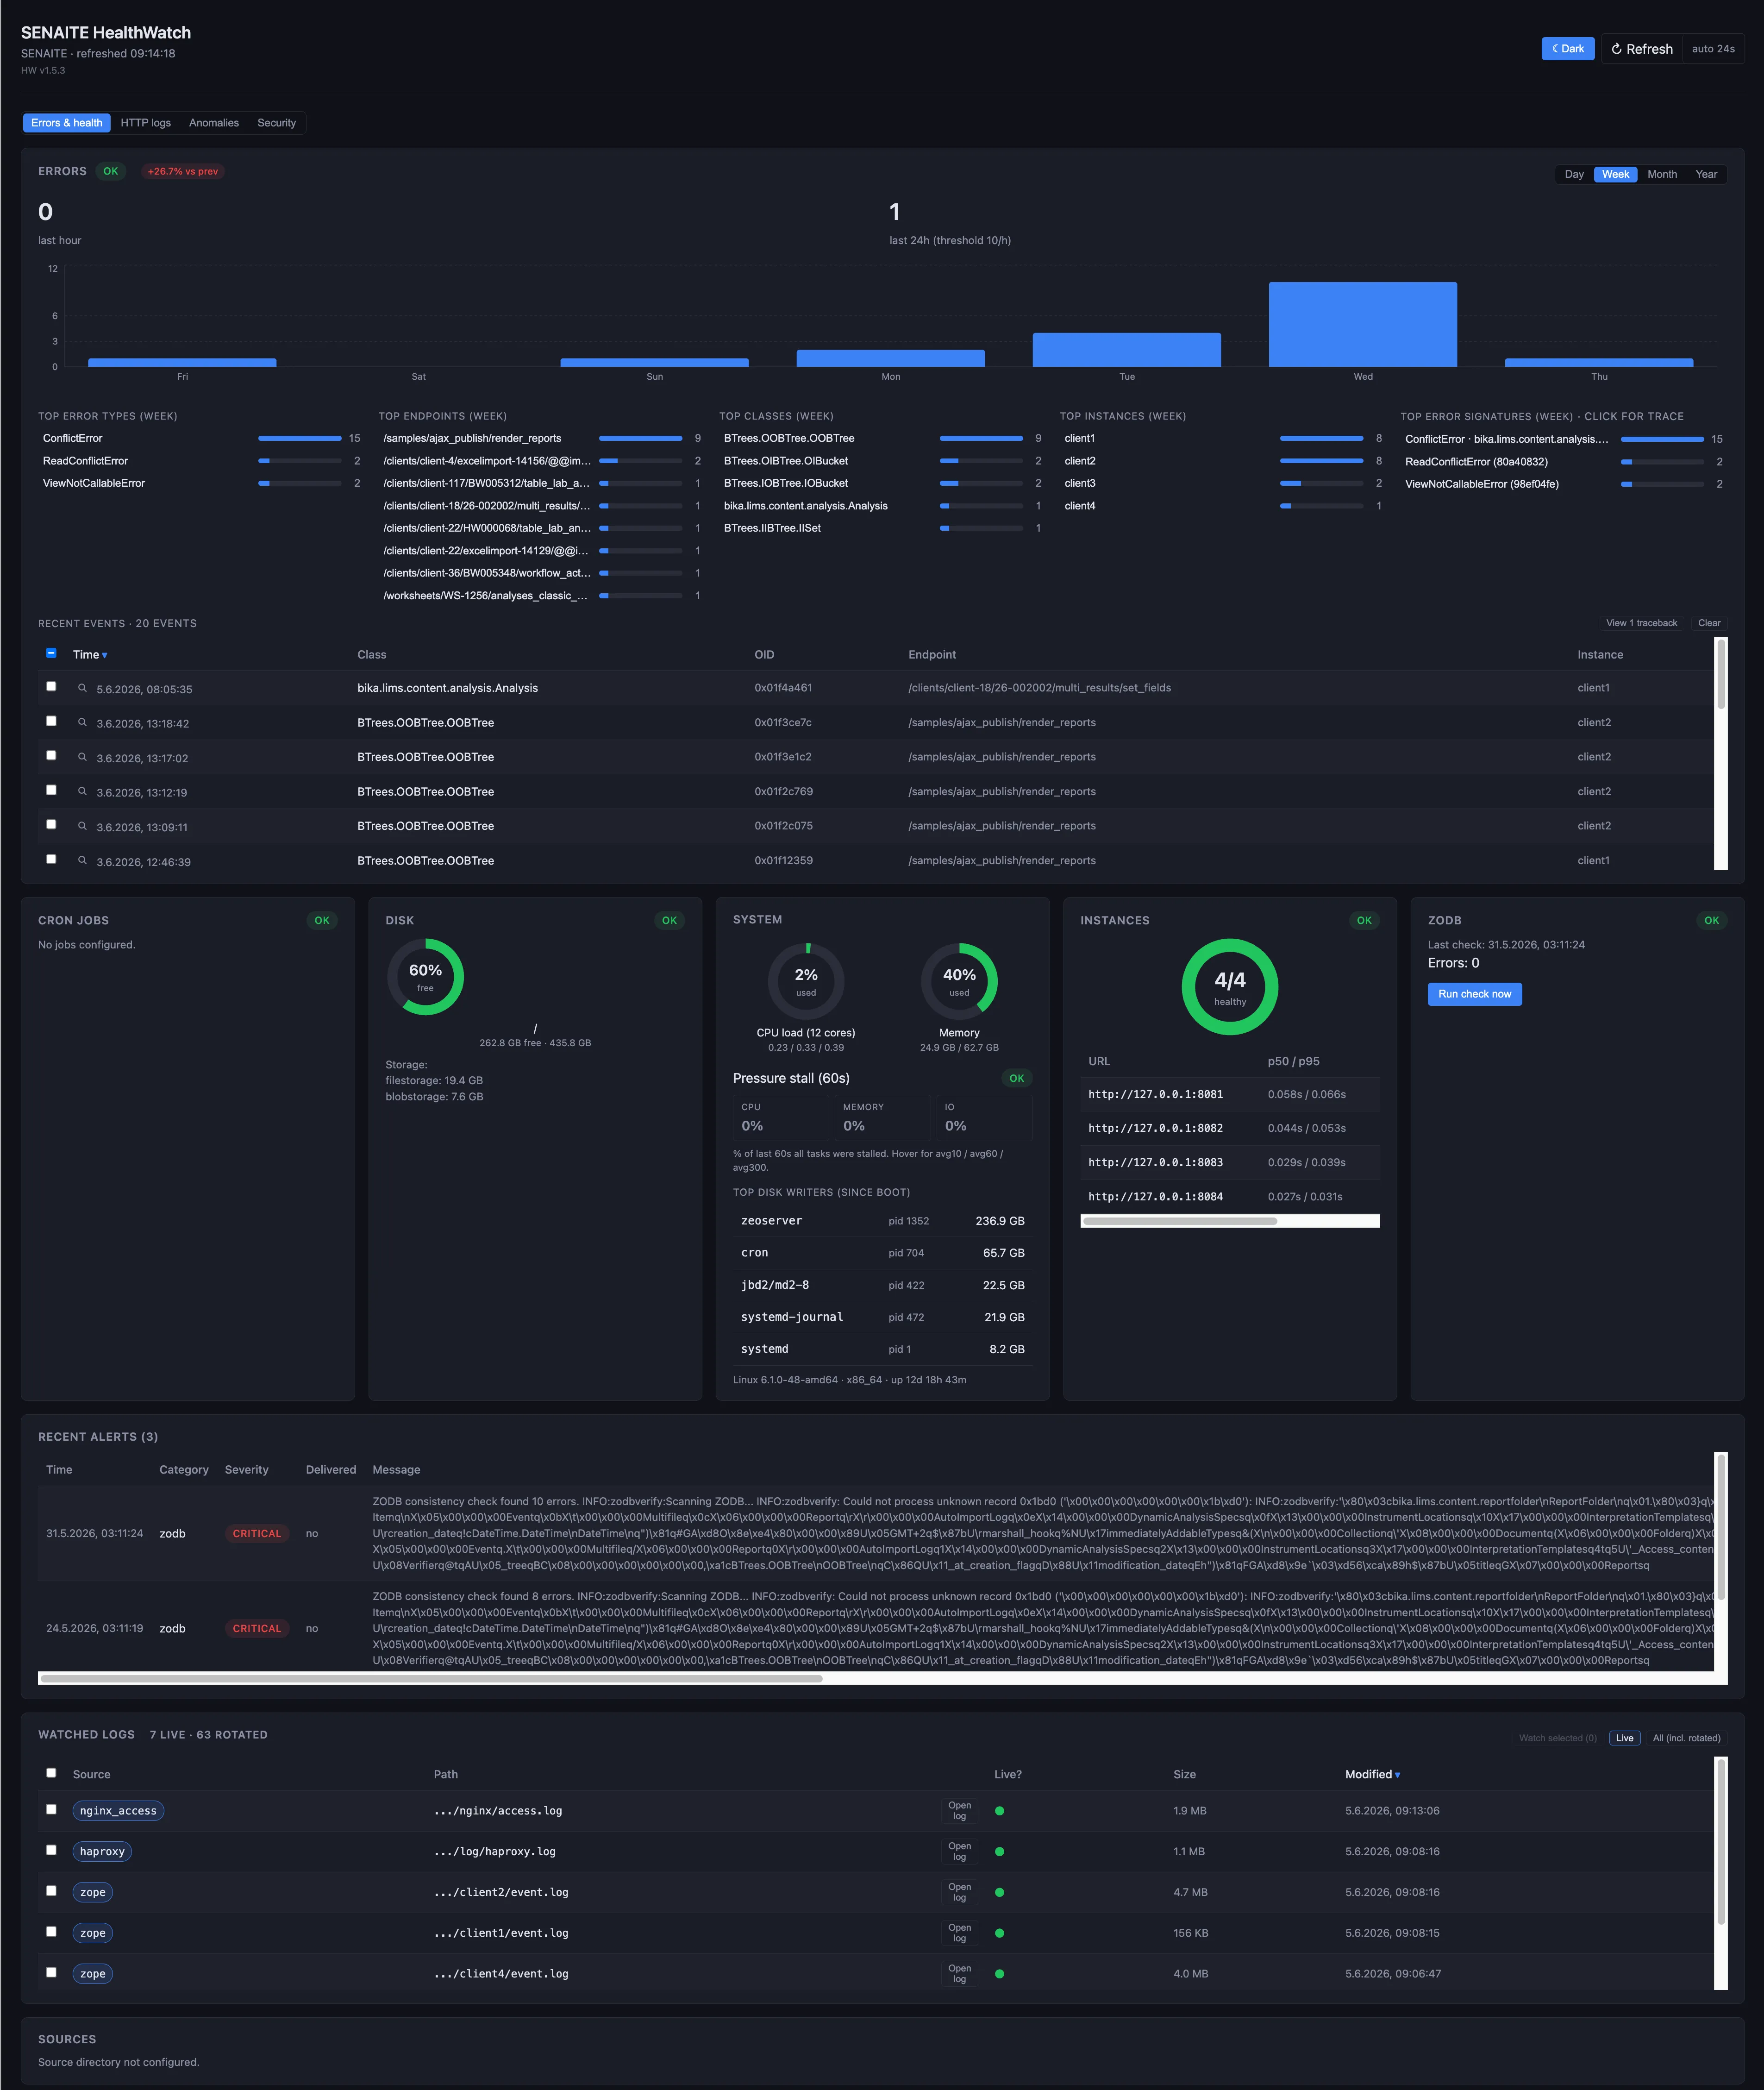
Wir haben HealthWatch gebaut, weil wir genau das für die Installationen brauchten, die wir betreuen. Es läuft neben SENAITE auf demselben Host, als eigener Prozess außerhalb der Anwendung, damit eine hängende Instanz das Monitoring nicht mitreißt. Es liest, was die Installation ohnehin erzeugt: die Logs der Instanzen, die Logs von nginx und HAProxy, das Log der ASTM-Geräteschnittstelle, das Kernel-Log. Das Ergebnis zeigt es auf einem Dashboard und verschickt Alarme per E-Mail oder an Zabbix.
Datenbank und Jobs
- Konsistenz. HealthWatch lässt
zodbverifygegen die Datenbank laufen, standardmäßig wöchentlich, und zählt die Fehler in der Ausgabe. Der letzte Teil ist wichtig, wenn Sie das selbst skripten:zodbverifyliefert keinen Fehlercode, wenn es beschädigte Datensätze findet. Eine Prüfung, die nur den Rückgabewert ansieht, ist deshalb immer grün. DerEOFErroraus dem Fall oben ist eine der Zeichenketten, nach denen es sucht. - Geplante Jobs. Backup und Pack melden sich bei HealthWatch, wenn sie fertig sind, mit einem einzigen HTTP-Aufruf am Ende des Cron-Jobs. Bleibt die Meldung innerhalb des erwarteten Intervalls plus Karenzzeit aus, schlägt HealthWatch Alarm. Ein Job, der still aufgehört hat zu laufen, fällt am nächsten Morgen auf und nicht Monate später durch Zufall.
- Backups. Neben der Aktualität vergleicht HealthWatch die Größe des neuesten Backups mit der des vorigen und warnt, wenn das Backup-Verzeichnis auf demselben Gerät liegt wie die Datenbank.
- Speicher. Freier Plattenplatz sowie die Größe von Datenbank und Anhangsspeicher, stündlich erfasst, damit das Wachstum zwischen zwei Packs als Verlauf sichtbar wird.
Instanzen und Anfragen
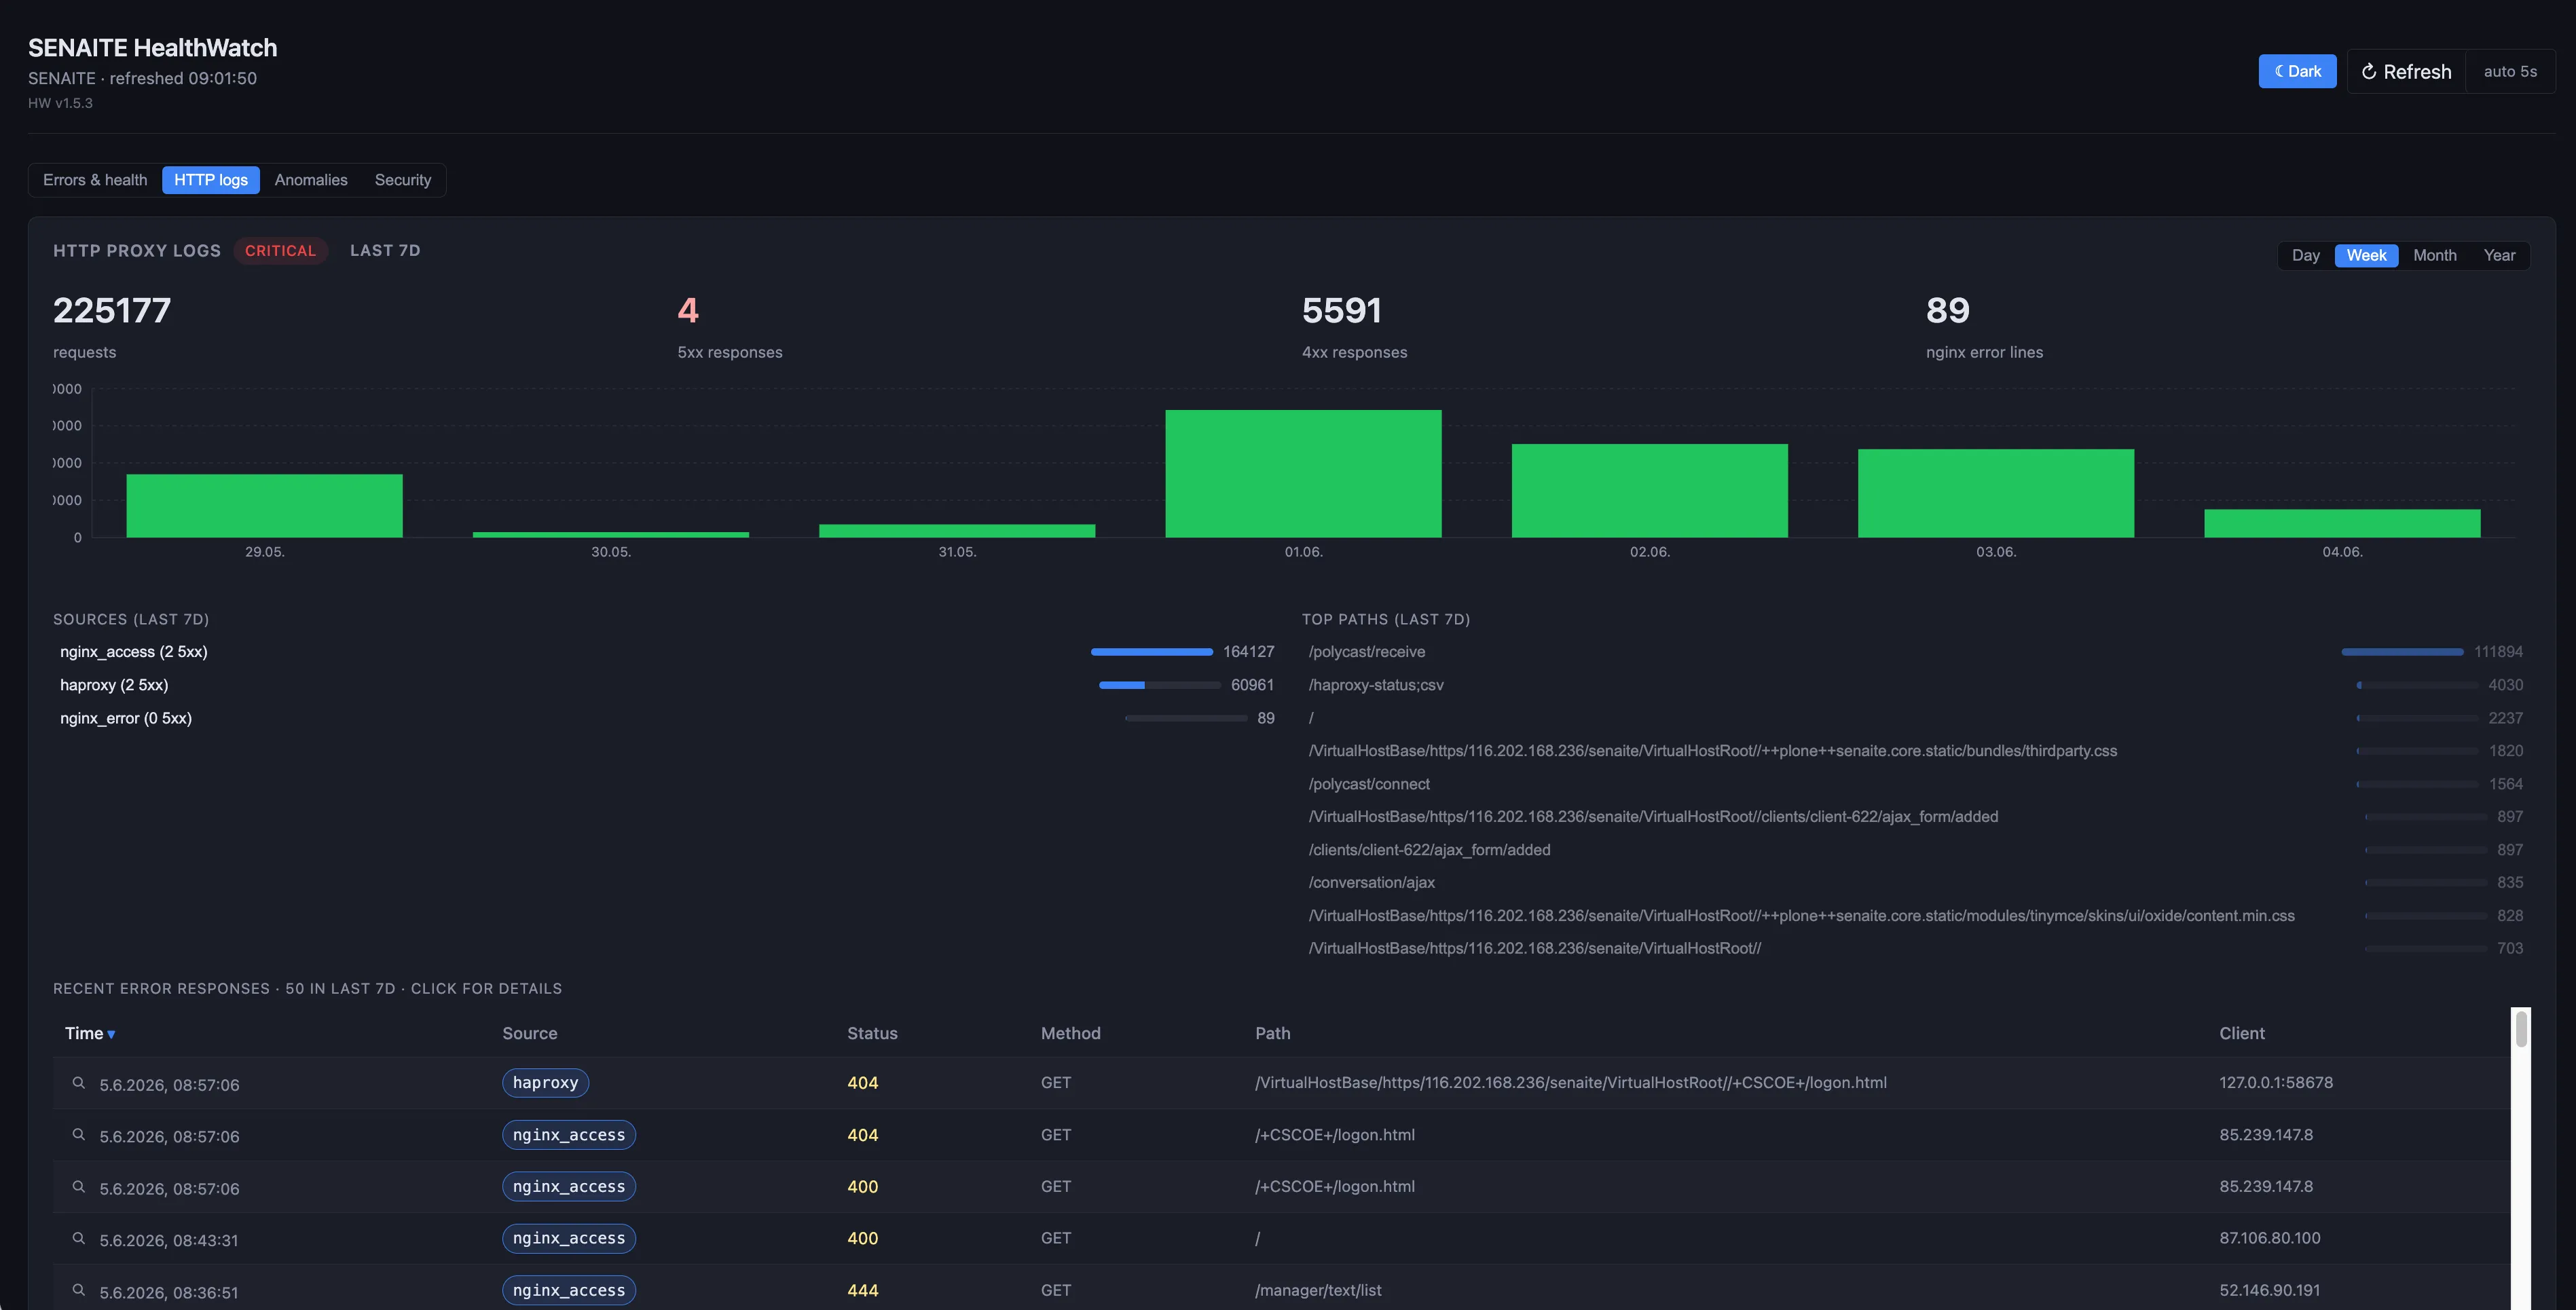
Jede Instanz wird alle fünf Minuten auf Erreichbarkeit und Antwortzeit geprüft. Der Reiter für die HTTP-Logs ordnet jede Anfrage aus nginx und HAProxy nach Status ein und listet die häufigsten Quellen und Pfade sowie die letzten Fehlerantworten. So lässt sich eine Verschlechterung verfolgen, ohne eine Logdatei zu öffnen.
Anomalien
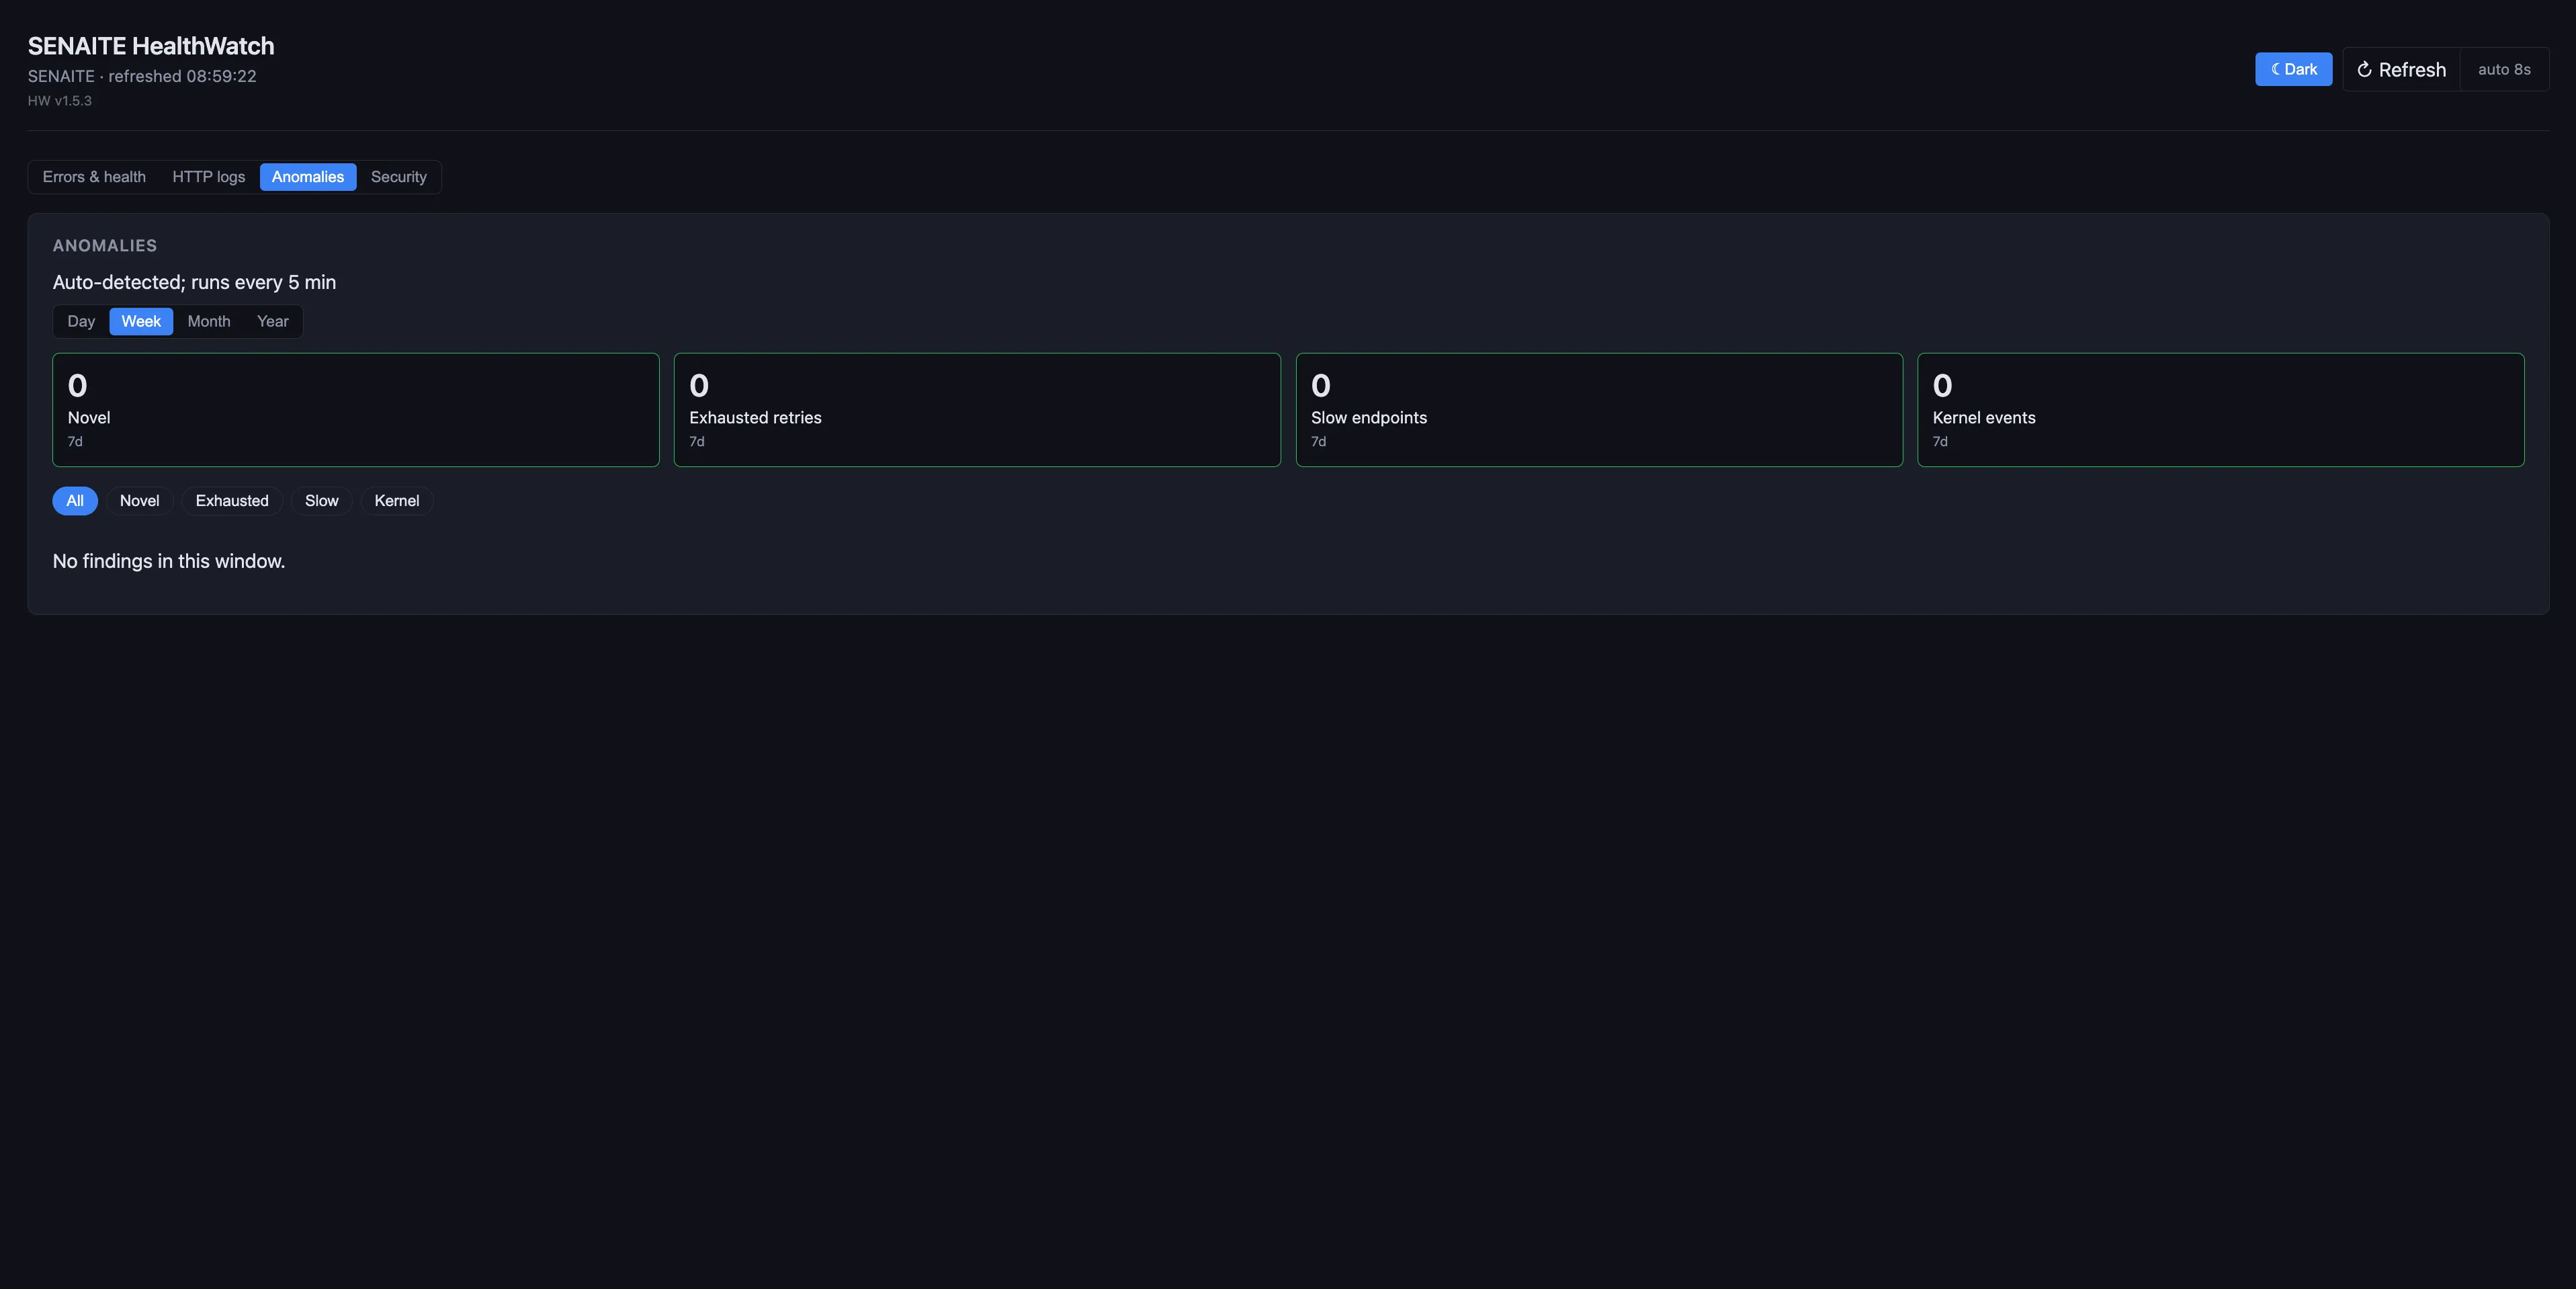
Manche Probleme sind keine Fehler im üblichen Sinn. Der Reiter Anomalien sammelt vier Arten:
- Neue Fehler. Ein Traceback, dessen Signatur in den vorangegangenen 30 Tagen nicht vorkam. Eine neue Fehlerart nach einem Update fällt beim ersten Auftreten auf.
- Ausgeschöpfte Wiederholungen. SENAITE wiederholt eine Anfrage, die auf einen Schreibkonflikt gestoßen ist. Erst wenn alle Wiederholungen scheitern, sieht der Benutzer einen Fehler. HealthWatch hält diese Fälle je Ansicht fest.
- Langsame Endpunkte. Für jede Ansicht wird das 95. Perzentil der Antwortzeit einer Stunde mit früheren Messungen derselben Wochenstunde verglichen. Montagmorgen wird mit Montagmorgen verglichen, nicht mit Sonntagnacht.
- Kernel-Ereignisse. Prozesse, die wegen Speichermangels beendet wurden, I/O- und Dateisystemfehler, hängende Tasks, Hardwarefehler, die die Maschine meldet.
Sicherheit
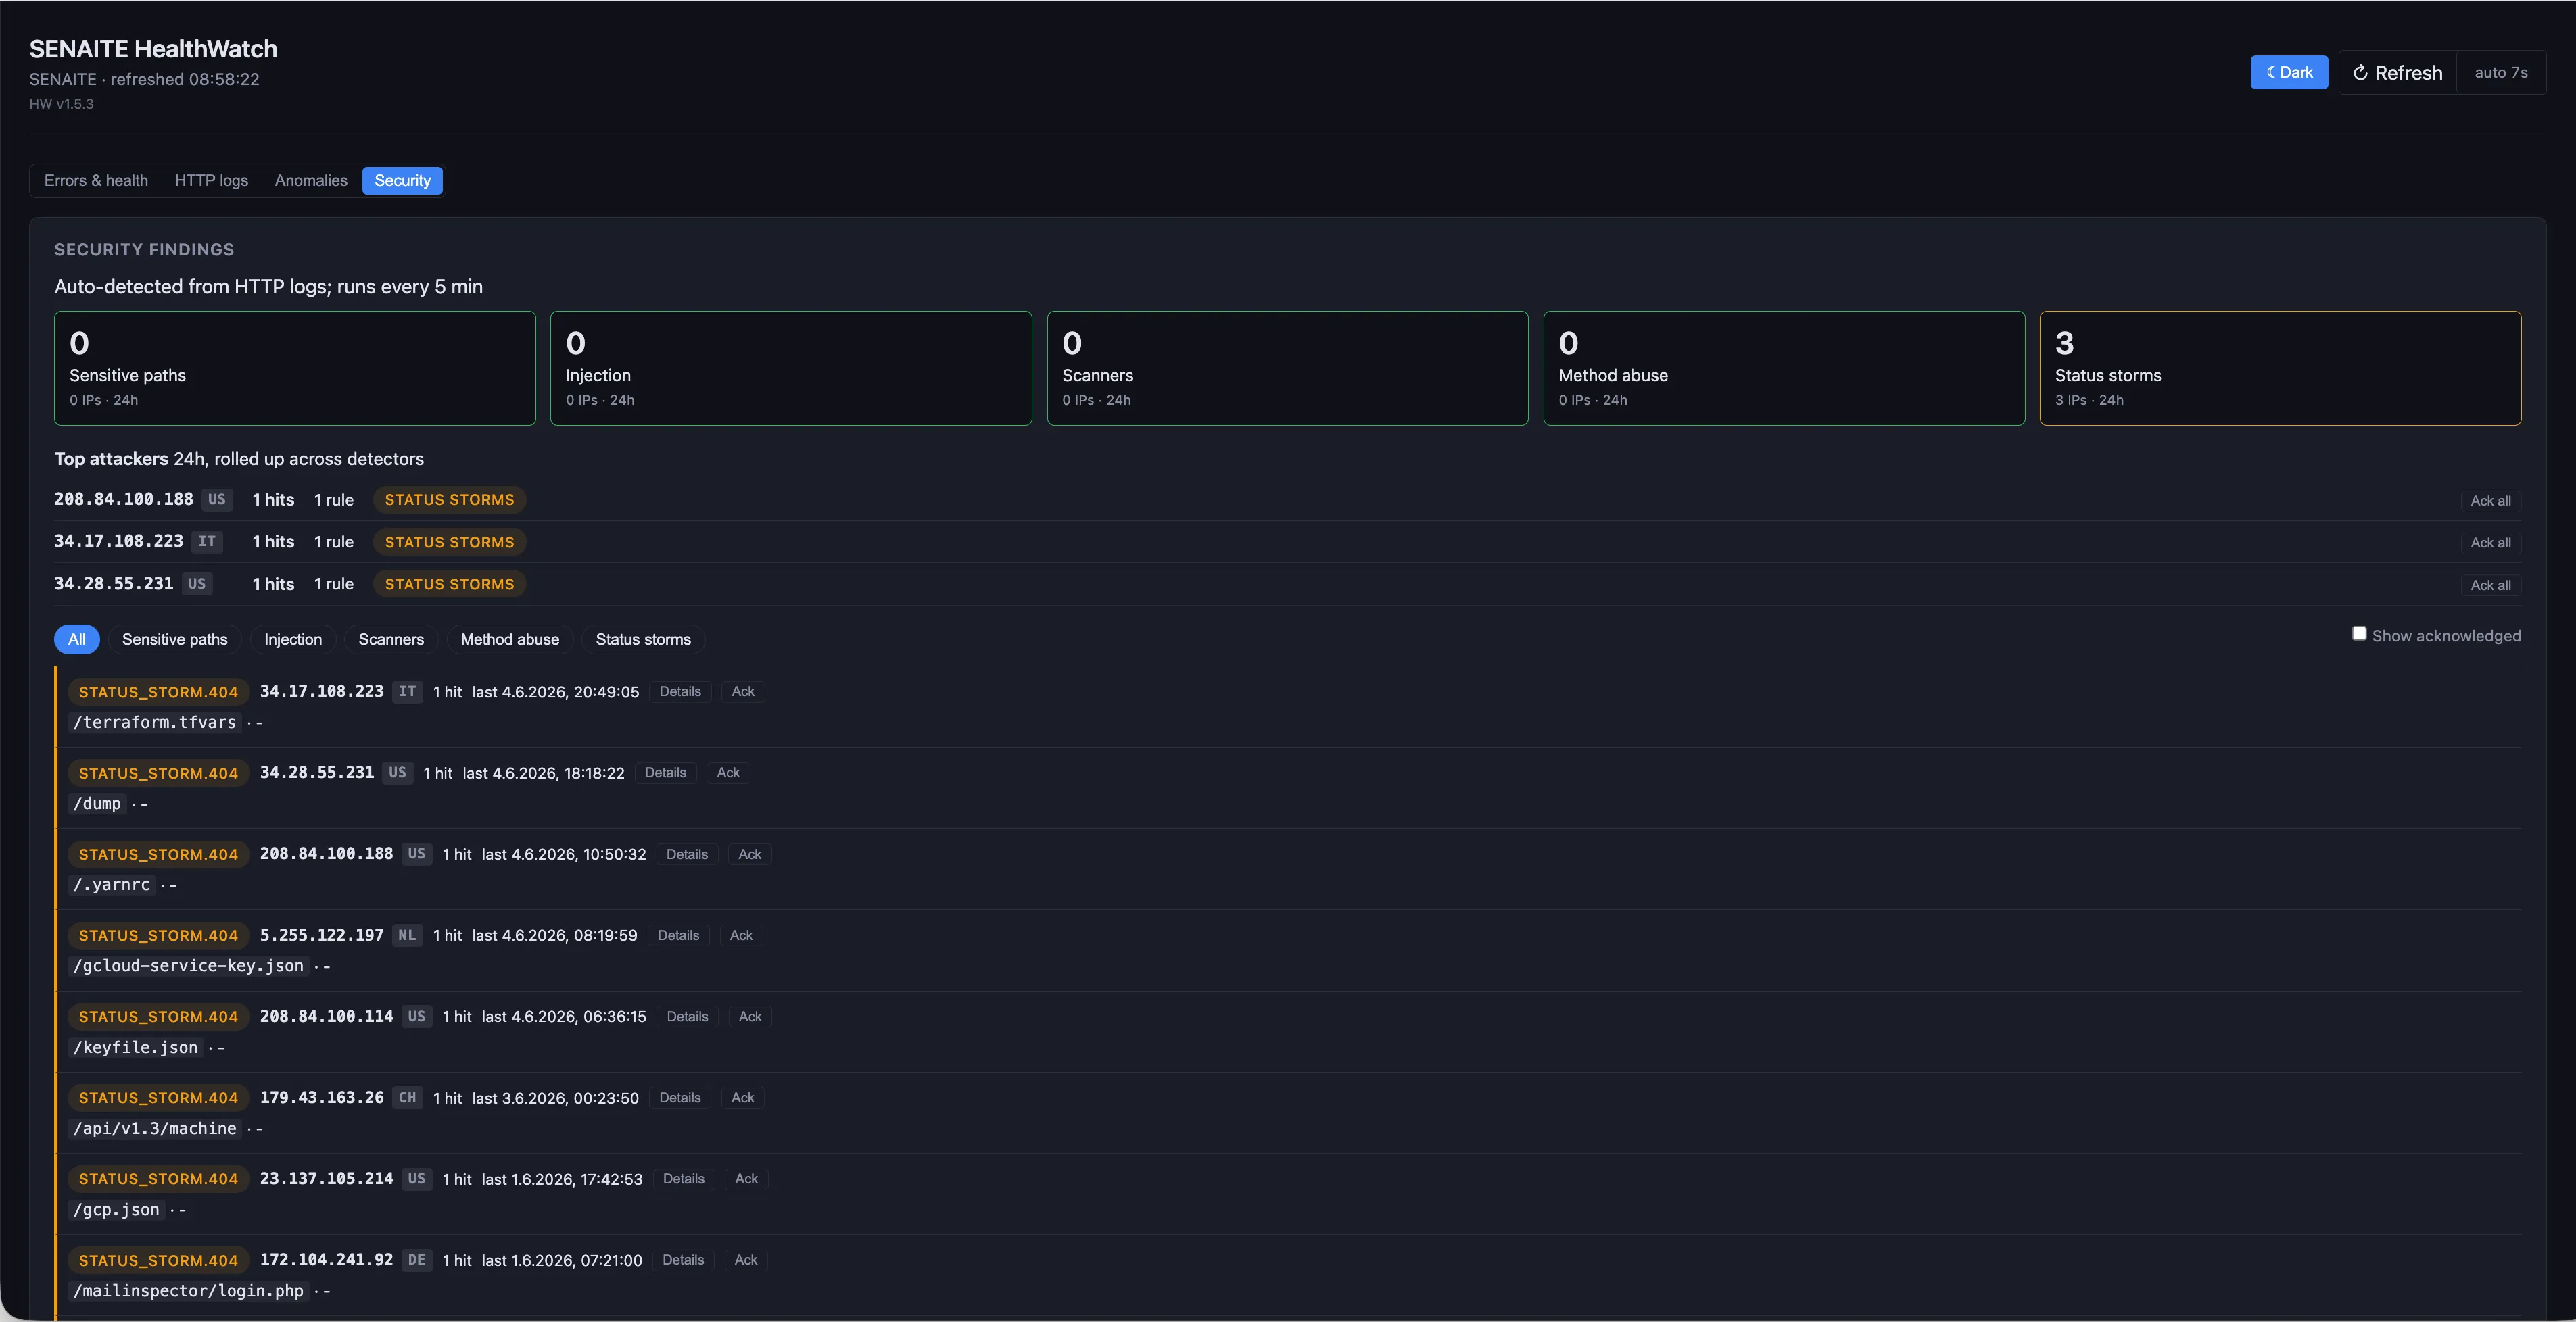
Der Reiter Sicherheit liest denselben Anfragestrom und markiert Anfragen auf sensible Pfade, Injektionsversuche, bekannte Scanner-User-Agents, ungewöhnliche HTTP-Methoden und Häufungen von 401-, 403- oder 404-Antworten von einer Adresse. Die Quellen dahinter werden mit ihren Befunden aufgelistet.
Vom Alarm zum Ticket
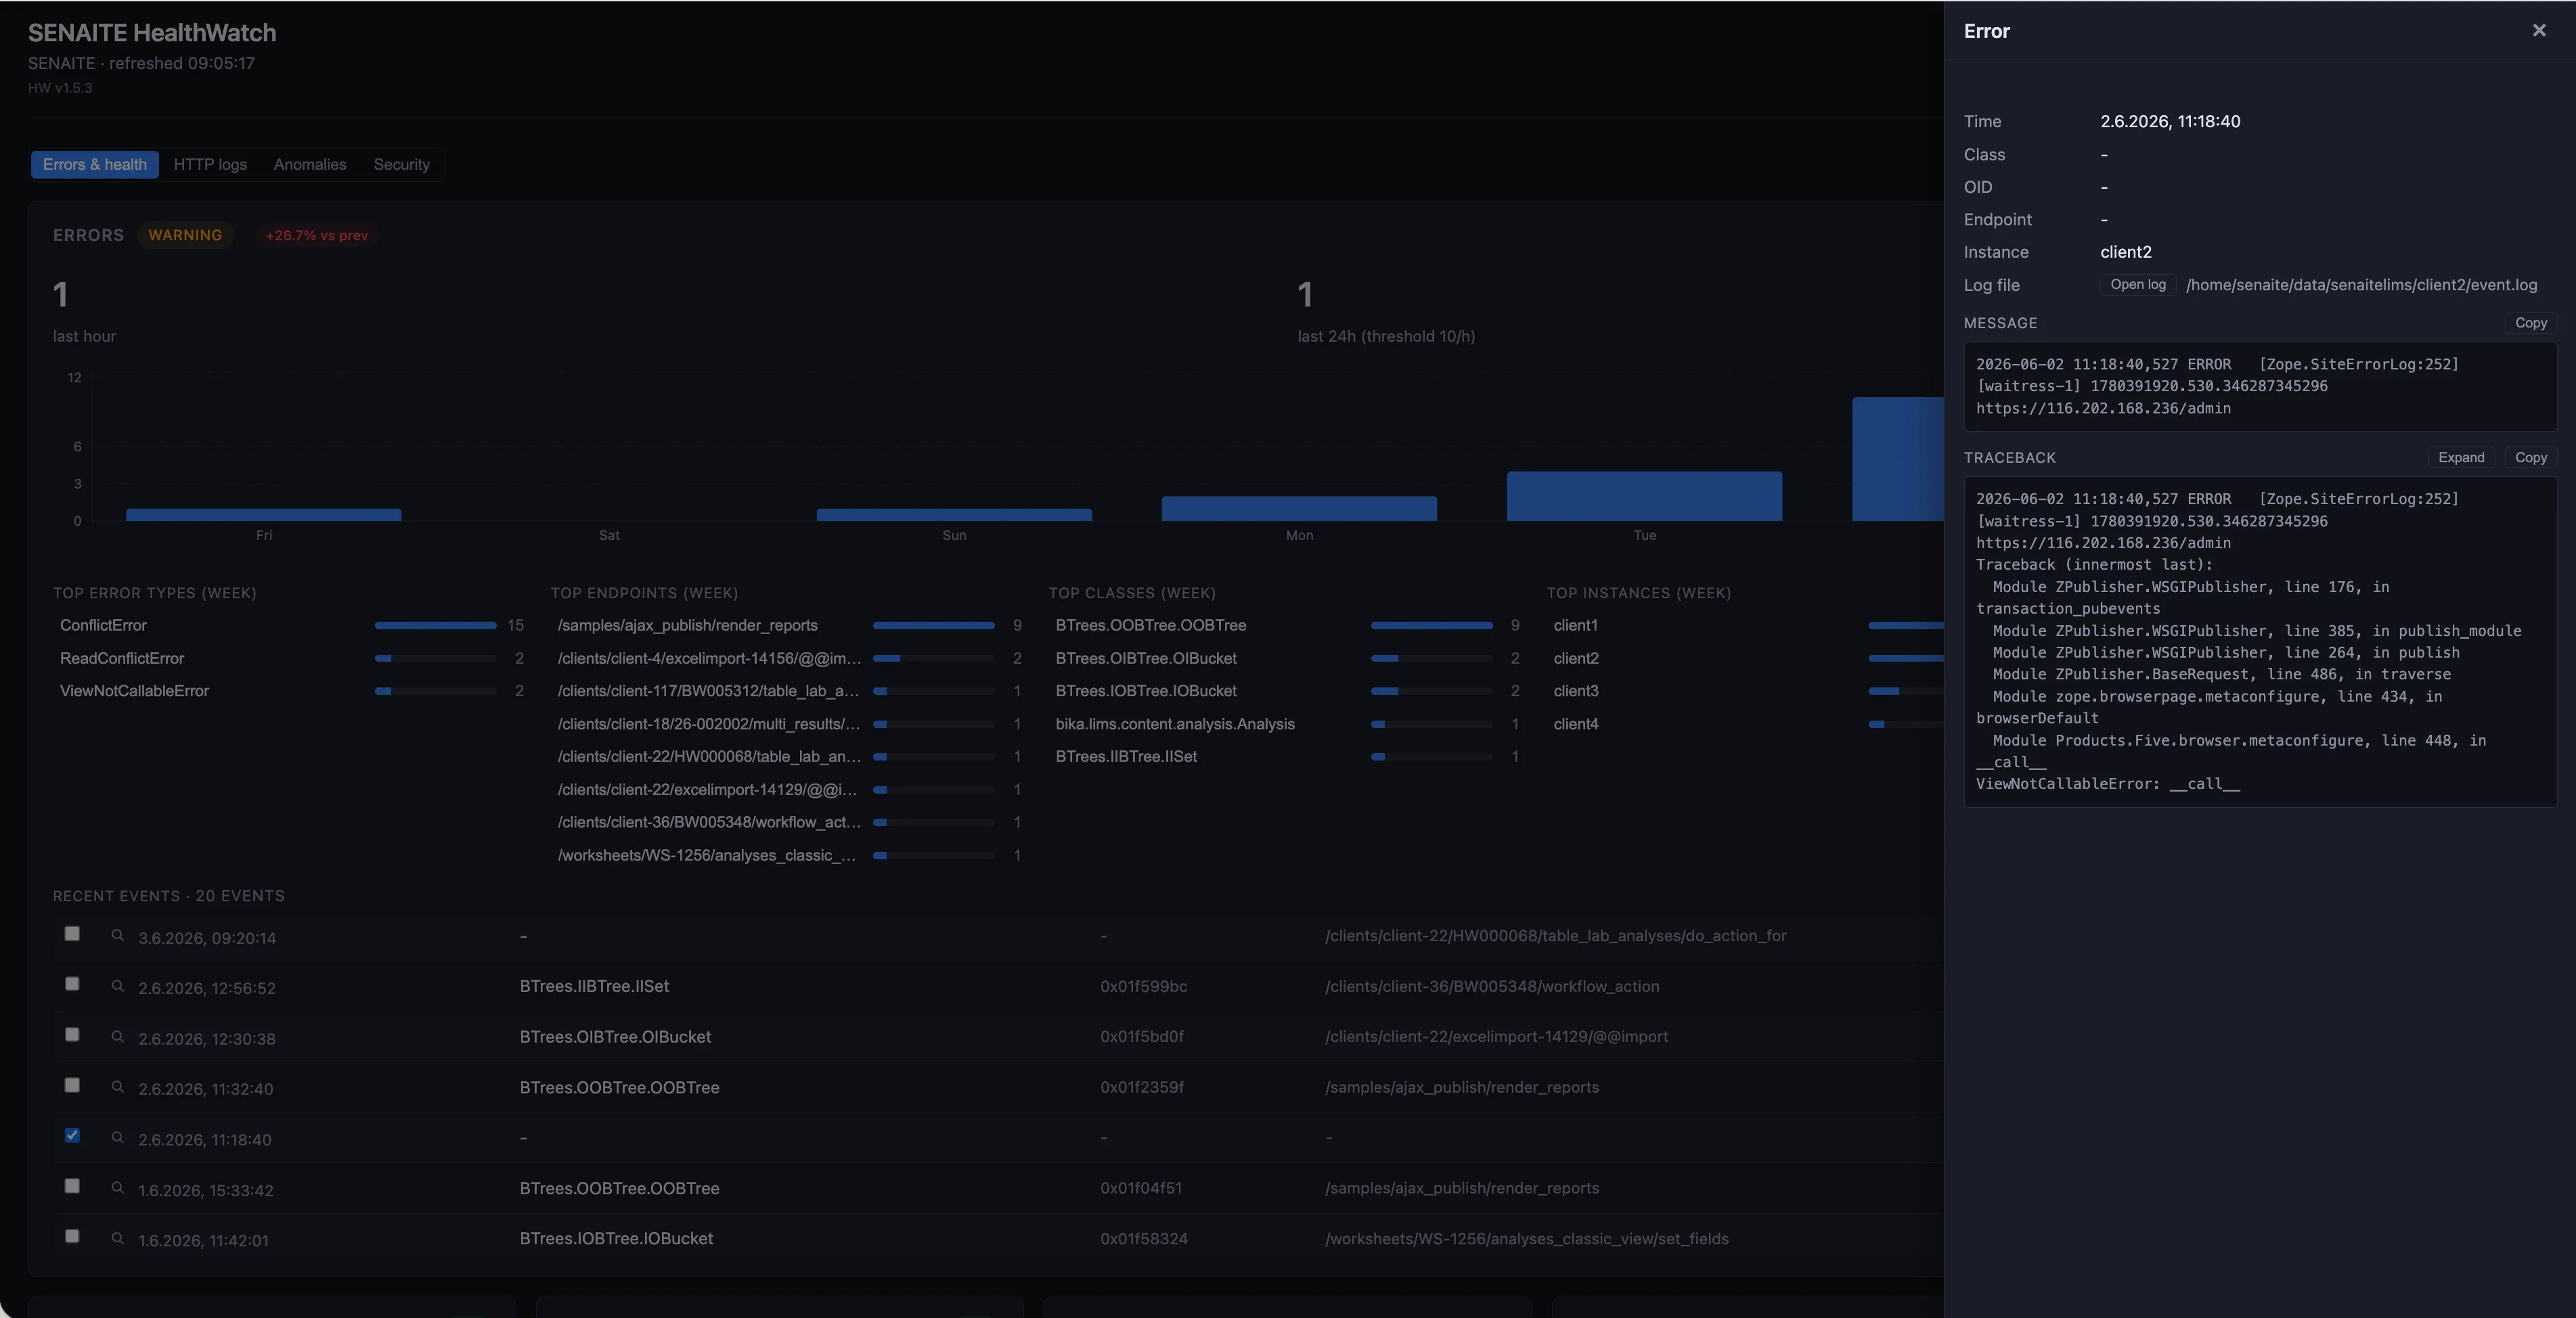
Ein Klick auf ein Ereignis öffnet seinen vollständigen Kontext: die Fehlerklasse, die Ansicht, die Instanz, die Logdatei, aus der es stammt, die Meldung und den vollständigen Traceback. Meldung und Traceback lassen sich mit einem Klick ins Ticket kopieren.
Was es kostet
Jeder Plan von SENAITE Care enthält HealthWatch. Alarme gehen an unsere Zabbix-Instanz und werden innerhalb der Arbeitszeiten und Reaktionszeiten des Plans bearbeitet. Professional ergänzt einen monatlichen Gesundheitsbericht als PDF, Enterprise wöchentliche Berichte. Essential beginnt bei 300 EUR im Monat.
Möchten Sie wissen, was wir auf Ihrer Installation finden würden, sprechen Sie uns an. Eine einmalige Gesundheitsprüfung verpflichtet Sie zu keinem Plan.
Vier Prüfungen für diese Woche
Ob mit HealthWatch oder ohne, diese Prüfungen lohnen sich auf jedem SENAITE-Server:
- Lesen Sie die Ausgabe Ihres letzten Packs. Packen Sie mit
bin/zeopack, starten Sie es einmal von Hand und lesen Sie, was es ausgibt. EinEOFErroroderPOSKeyErrorheißt, dass der Pack seine Arbeit nicht tut. - Vergleichen Sie die Größe von
Data.fsmit der vor drei Monaten. Ein Pack, der läuft, lässt die Datei ab und zu schrumpfen. Wächst sie nur, läuft der Pack nicht oder wirkt nicht. - Prüfen Sie, wo die Backups liegen. Liegen sie auf derselben Platte wie die Datenbank, nimmt ein Plattenausfall beides mit.
- Stellen Sie ein aktuelles Backup auf einer anderen Maschine wieder her. Öffnen Sie eine Probe mit Anhang. Das dauert eine Stunde und ist die einzige Prüfung, die beweist, dass die Backups brauchbar sind.