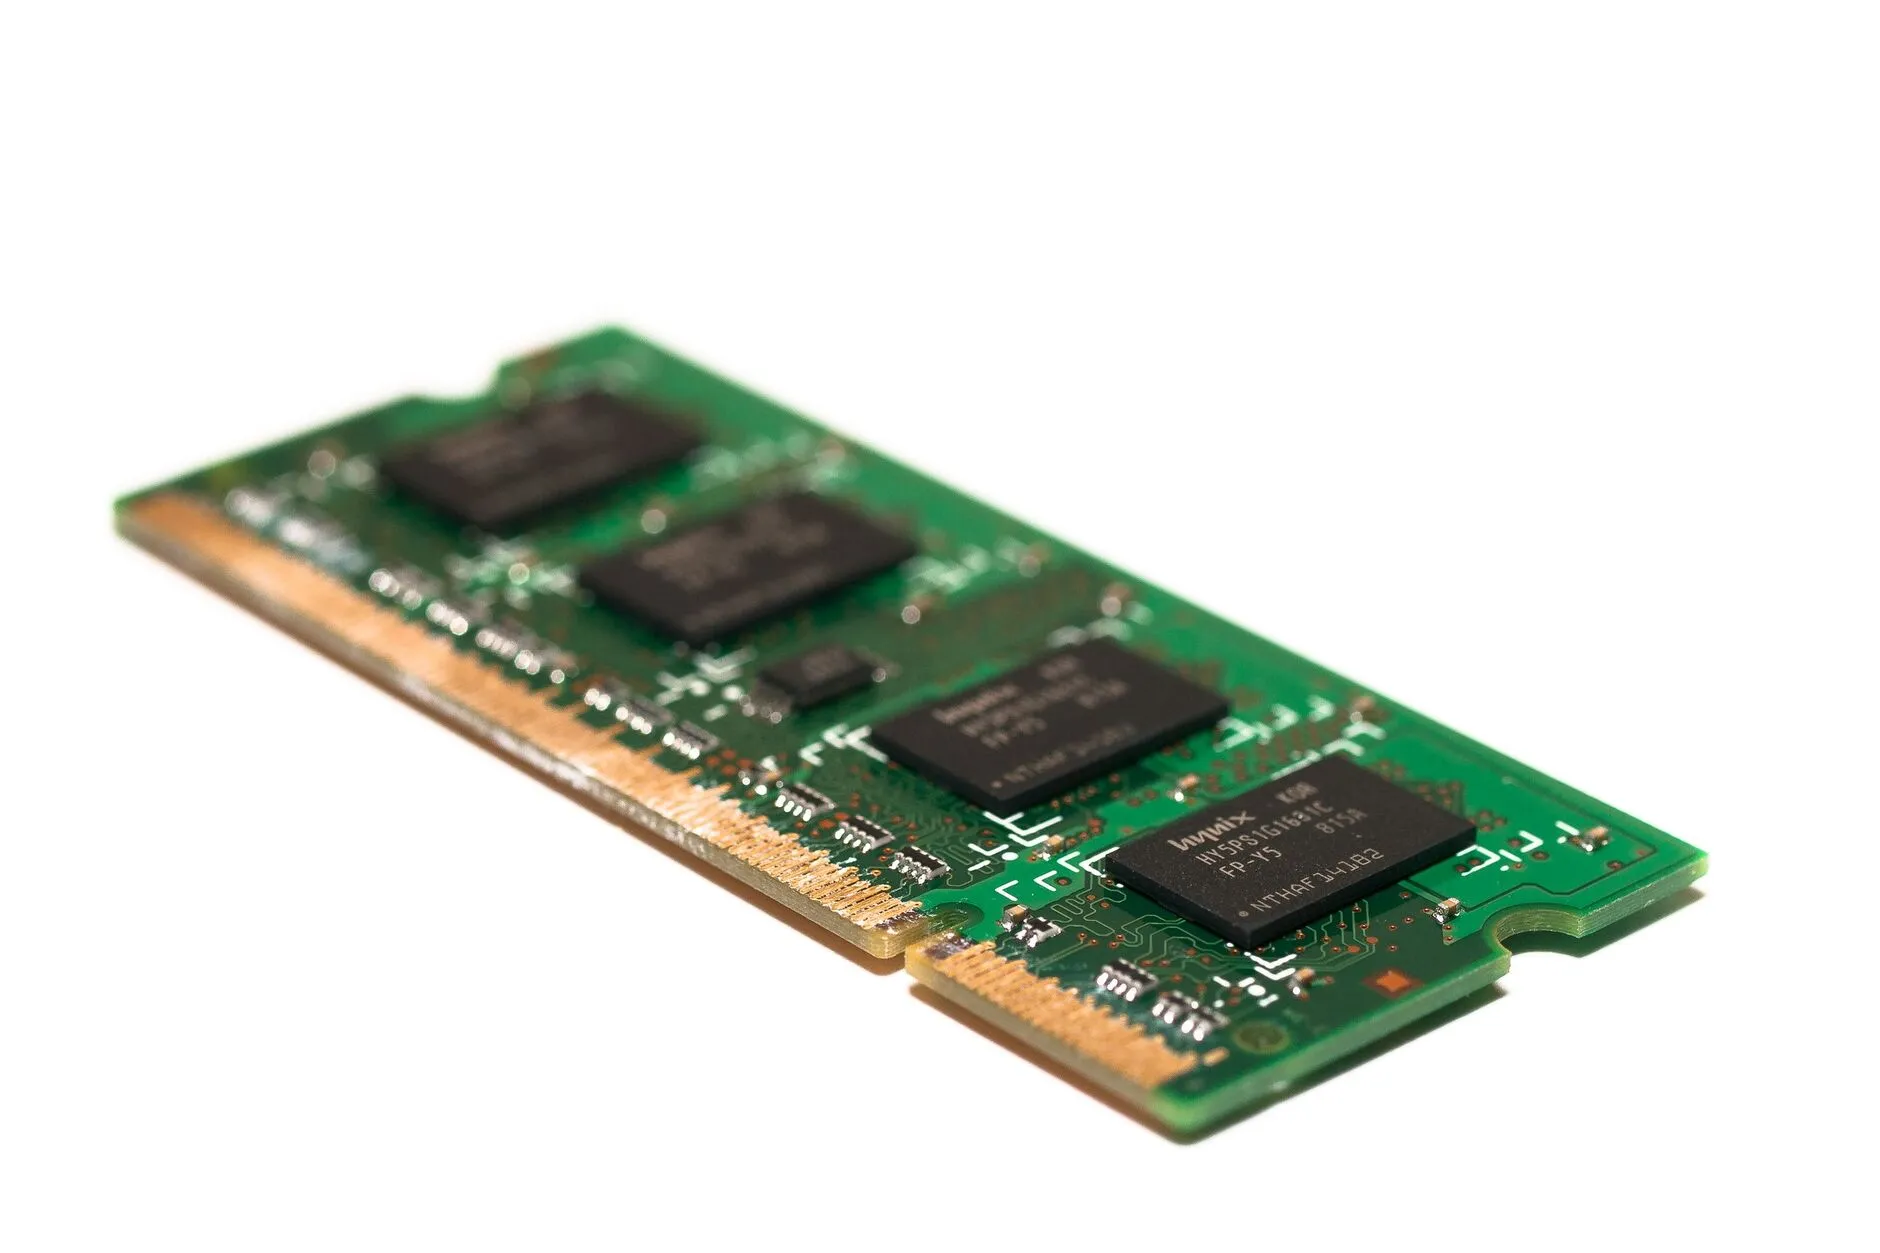
Die meisten Serverausfälle sind laut: Eine Platte stirbt, ein Prozess stürzt ab, die Site ist weg. Speicherfehler sind oft leise. Ein einzelnes Bit kippt in einem Speichermodul, und was dort lag, ist nun ein wenig anders. War es eine Zahl auf dem Weg in die Datenbank, speichert die Datenbank die falsche Zahl.
Wir haben das auf einem SENAITE-Server erlebt. Ein gekipptes Bit beschädigte einen Verweis in der Objektdatenbank. Das Kernel-Log blieb leer, denn der Server hatte Speicher ohne Fehlerkorrektur, und solcher Speicher kann nicht bemerken, geschweige denn melden, dass sich ein Bit geändert hat. Der Schaden zeigte sich erst, als etwas diesen Teil der Datenbank lesen wollte.
Was ECC tut
ECC-Speicher legt zu jedem Wort zusätzliche Prüfbits ab. Der Speichercontroller korrigiert Einzelbitfehler im laufenden Betrieb und erkennt Fehler, die er nicht korrigieren kann, statt der Anwendung verfälschte Daten zu liefern. Unter Linux zählt der EDAC-Treiber des Kernels beide Arten, und die Zähler lassen sich aus dem Dateisystem lesen.
Daraus ergeben sich für jeden Server, auf dem ein LIMS läuft, zwei getrennte Fragen:
- Hat der Server überhaupt ECC-Speicher?
- Wenn ja: Werden Fehler gezählt?
Was HealthWatch prüft
HealthWatch beantwortet beide, auf jedem Host, den es überwacht.
Die Ausstattung, einmal am Tag. Es liest die
Speicherbeschreibung der Firmware (dmidecode -t memory) und
erfasst für jedes eingebaute Modul, dessen Fehlerkorrektur None
lautet, einen kritischen Befund. Diese Prüfung hätte den Server
oben lange vor dem gekippten Bit gemeldet. Sie braucht ein
installiertes dmidecode und Root-Rechte; ohne sie erfasst die
Prüfung nichts, die Zähler unten funktionieren trotzdem.
Die Zähler, bei jedem Durchlauf. Es liest die EDAC-Zähler unter
/sys/devices/system/edac/mc/ für jeden Speichercontroller:
- ein nicht korrigierbarer Fehler (
ue_countüber null) ist kritisch: Die Hardware hat einen Fehler erkannt, den sie nicht beheben konnte - eine steigende Zahl korrigierter Fehler (
ce_count) ist eine Warnung: Das Modul altert und sollte getauscht werden, bevor der nächste Fehler einer ist, den es nicht mehr korrigieren kann - ein EDAC-Treiber ohne registrierten Speichercontroller ist ebenfalls eine Warnung. Meist steckt ein Chipsatz dahinter, der ECC nicht unterstützt, auch wenn die Module es angeben
Die Befunde erscheinen im Reiter Anomalien, neben Kernel-Ereignissen wie Machine-Check-Exceptions, die HealthWatch bereits aus dem Kernel-Log aufnimmt. Eine Häufung korrigierter Fehler wird einmal pro Stunde erfasst, nicht einmal pro Fehler.
Den eigenen Server prüfen
Zwei Befehle beantworten die beiden Fragen auf jedem Linux-Server:
sudo dmidecode -t memory | grep -i "error correction"
grep . /sys/devices/system/edac/mc/mc*/ce_count \
       /sys/devices/system/edac/mc/mc*/ue_count
Error Correction Type: None heißt: kein ECC. Findet der zweite
Befehl keine Dateien, hat der Kernel keinen EDAC-Treiber für den
Speichercontroller, und korrigierte Fehler werden nirgends gezählt.
Auf einer virtuellen Maschine beschreiben beide Befehle, was der Hypervisor vorgibt, nicht den physischen Speicher darunter. Ob der Host ECC verwendet, müssen Sie den Betreiber fragen. Bei einem gemieteten Server gehört die Frage vor die Unterschrift.
Warum das für ein Labor zählt
Ein Ergebnis, das ein Speicherfehler verändert hat, sieht aus wie jedes andere. Ist es plausibel, besteht es die Verifizierung und landet auf einem unterschriebenen Bericht. Hinterher kann niemand zeigen, ob die Zahl falsch eingegeben oder später verändert wurde, weil nichts die Änderung festgehalten hat. Für ein akkreditiertes Labor ist das eine schwierige Ausgangslage.
ECC-Speicher im LIMS-Server und eine Prüfung, dass er arbeitet, kosten wenig im Vergleich dazu.
So bekommen Sie es
Die ECC-Prüfung ist Teil von HealthWatch, das in jedem Plan von SENAITE Care enthalten ist. Betreiben Sie Ihren SENAITE-Server selbst und wissen nicht genau, welcher Speicher darin steckt, beginnen Sie mit den zwei Befehlen oben. Zeigen sie etwas, das Ihnen nicht gefällt, sprechen Sie uns an.